
【智慧專欄】同一支 SQL,為什麼突然變慢?從 PostgreSQL 統計資訊看 APS 查詢效能
作者:陳柏翰
宇清數位|PD部門
當 APS 正在展開工單、比對途程與模擬產能時,一支關鍵 SQL 的延遲,就可能拉長整輪排程等待。同樣的程式、同樣的主機,為什麼昨天順暢,今天匯入資料後卻突然變慢?答案可能藏在 PostgreSQL 對資料的認識,以及它據此選擇的執行方式。
解析 PostgreSQL 效能關鍵:也需要一份準確的現場情報
生管安排生產前,需要知道待製品數量與機台負載;PostgreSQL 規劃查詢時,也需要預估篩選後剩下多少資料、兩張表能配出多少筆結果,再比較不同路徑的成本。這份情報來自資料表規模與欄位分布等統計。若某類急單原本很少,批次匯入後卻大量增加,而統計尚未反映變化,規劃器就可能低估工作量,連帶影響掃描方式、JOIN 順序與配對方法。
用 pg_stats 看資料庫掌握的資料輪廓
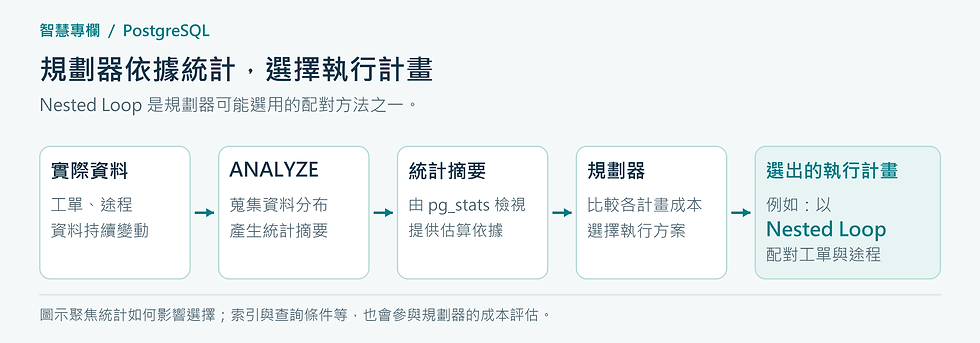
要確認規劃器是否仍把大量急單當成少數,可以透過 pg_stats 查看圖一中的統計摘要。它呈現的是資料庫掌握的分布輪廓,例如哪些工單狀態最常見、產品種類多不多,以及交期集中在哪些區間。這些資訊協助規劃器估算「指定條件會留下多少資料」。例如,待排工單原本只占少數,現在卻占了大半,合理的讀取與配對方式就可能跟著改變。IT 團隊可將統計摘要與業務已知的資料變化對照,判斷是否需要更新統計。讀懂這層用途,就能理解 pg_stats 與效能的關係:它讓人看見規劃器正在依據什麼情報做決定。官方說明:pg_stats
ANALYZE 指令:讓統計跟上批次作業以維持最佳效能
查看 pg_stats 是了解現況;若統計與資料變化有落差,下一步就是更新。ANALYZE 會蒐集資料分布統計,大型資料表通常採抽樣,因此結果仍是估計值。它負責更新規劃依據,不會替資料表建立索引。官方說明:ANALYZE
對 APS 而言,適合安排它的時點,是大量工單匯入、狀態批次更新完成後,以及後續重度查詢開始前。例如:ANALYZE public.work_order; 一般資料表可由 autovacuum 的自動分析機制維護,但觸發門檻與工作排程可能形成時間落差。若批次完成後立刻展算,就應評估將分析納入批次流程。尤其 APS 常用暫存表承接中間結果,autovacuum 無法處理暫存表,填入大量資料後須由該連線安排 ANALYZE。官方說明:統計維護與自動分析
認識三種 JOIN 演算法
統計更新後,規劃器就能重新評估適合的執行方式。其中,將兩份資料配在一起,主要有 Nested Loop、Hash Join、Merge Join 三種基本演算法。它們各有準備成本與適用情境,重點是方法是否符合這次要處理的資料。官方說明:規劃器與 JOIN 演算法
圖二用資料 A、資料 B 表示兩份待配對的資料。「配對鍵」是用來找相符紀錄的欄位,例如兩份資料都有的客戶編號;以下以鍵值相等的配對為例。

Nested Loop:取一筆,就查一次
從資料 A 取出一筆,到資料 B 找相符紀錄,再繼續處理 A 的下一筆。當 A 筆數少、B 又有合適索引時,每次查找很快,通常有利。若 A 比預期多很多,或每次查找都很費力,重複工作的總成本就會升高。
Hash Join:先建立查找表,再批次配對
先依配對鍵將資料 B 建成雜湊表,再逐筆用 A 的鍵值查找相符紀錄,常適合大量等值配對。它需要先付出建表時間與記憶體成本;資料量大到記憶體容納不下時,可能分批並使用磁碟暫存,增加 I/O。
Merge Join:按配對鍵排序,再依序比對
將 A、B 都按配對鍵排列,沿順序比較,遇到相同鍵值就組合相符紀錄。若兩份資料已由索引或前面的處理提供合適順序,就能省下額外排序;若必須先排序大量資料,時間與磁碟暫存成本也要計入。官方說明:Merge Join 的配對條件
三種方法的操作差異可參考 PostgreSQL 規劃器文件。排序與雜湊的記憶體限制則與 work_mem 有關;雜湊操作還受 hash_mem_multiplier 影響。調高前須考量多節點、多連線同時執行的總量。
估錯工作量,如何放大查詢成本?
以 Nested Loop 為例:規劃器預估資料 A 只有 100 筆,因此選擇逐筆到 B 進行索引查找;實際 A 卻有 100,000 筆。假設 A 的每筆資料都需要到 B 查找一次,查找次數就會增加到預期的 1,000 倍。
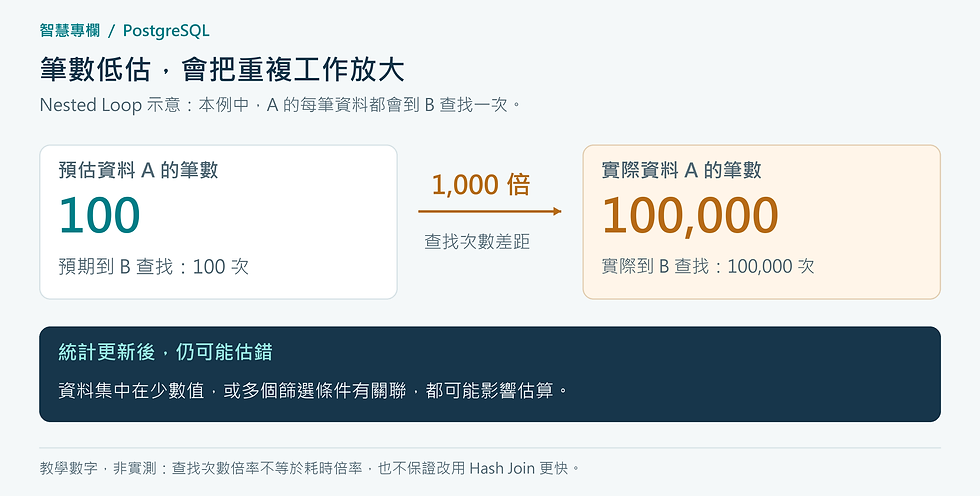
這時應先確認統計是否過時。若更新後仍低估,可能是某些值特別集中,需要蒐集更細的分布資訊。另一種情況是:查詢同時使用彼此相關的欄位,但規劃器手上只有各欄分開的統計。一般的 ANALYZE 不會自動替所有欄位組合蒐集統計;若未另外指定並蒐集相關組合,即使各欄統計已更新,仍可能無法掌握它們之間的關係。
用地址來想就容易理解:假設某個郵遞區號只屬於一座城市,找出這個郵遞區號的地址後,再加上「位於該城市」的條件,結果筆數其實不會減少。郵遞區號與城市有關聯,兩個條件並不是各自再篩掉一部分資料。若規劃器不知道這層關係,就可能把結果估得太少。
為了補上這種關係,可以用 CREATE STATISTICS 指定要一起觀察的欄位,再執行 ANALYZE 蒐集資料。這份同時描述多個欄位關係的摘要,稱為「多欄位統計」,能幫助規劃器估算同一張表篩選後的資料量,進而選擇適合的 JOIN 方法。官方說明:欄位統計與多欄位統計
讓資料庫的判斷,跟上工廠的變化
APS 的價值在於協助企業及時比較急單、產能與交期方案。當資料變化頻繁,IT 團隊應在大量匯入後更新統計,並在關鍵查詢前加上 EXPLAIN,查看預計採用的處理步驟與 JOIN 方法。EXPLAIN 顯示的是執行計畫與估算資訊,改善效果仍須以實際查詢時間確認。官方說明:EXPLAIN
掌握 pg_stats,能看見資料庫目前理解的分布;適時執行 ANALYZE,能更新規劃依據;讀懂三種 JOIN,則能解釋成本如何產生。當這三件事形成持續驗證的循環,排程團隊就更有機會在需要決策的時間內,取得可用的結果。

留言